LogStream: por que construí minha própria ferramenta de logs (sabendo que não deveria)
Do echo no PHP procedural ao error_log no cPanel, passando pela Inovação, pelo CrispyWaffle e por quatro anos de Seq: por que criei o LogStream, um servidor de logs em PHP/ReactPHP com UI em React, para rodar numa VM de 1 GB — e o que eu troquei por isso.
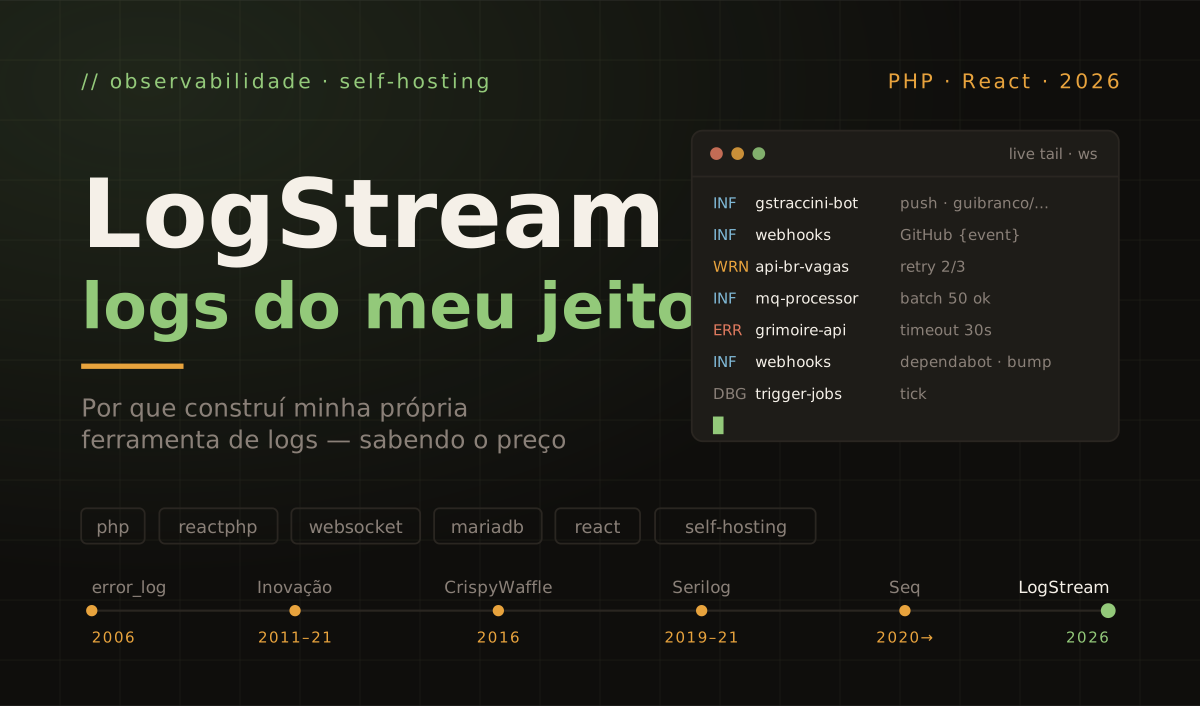
Eu sei que, para quase todo mundo, a resposta certa para "preciso de uma ferramenta de logs" é usar uma pronta. Eu digo isso para os outros. E mesmo assim passei os últimos meses construindo a minha: o LogStream, um servidor de ingestão de logs em PHP com uma UI em React. Este texto conta por que, de onde vieram as ideias, como ele funciona por dentro e — principalmente — o que eu abri mão para ter uma ferramenta feita sob medida para a minha infraestrutura.
Os dois repositórios são públicos: o logstream-server (PHP 8.3 + ReactPHP + Ratchet) e o logstream-ui (React + Vite + TypeScript). A instância que eu uso no dia a dia roda só na rede interna, e uma versão de demonstração pública está a caminho.
Vinte anos procurando erro
Comecei a programar bem antes do primeiro emprego formal, em 2011: meus primeiros projetos pessoais são do fim de 2006, e os primeiros freelas, de 2008. Nessa época de estudo e de freelas, era PHP procedural — e depois um PHP orientado a objetos ainda engatinhando. Debug era echo, print_r e var_dump espalhados no código até a coisa funcionar. Sem Xdebug, sem ferramenta de log, sem teste unitário, sem teste de integração. Quando o código amadurecia o suficiente para ir para produção, os erros que escapavam iam parar num lugar só: o error_log.
Esse hábito sobreviveu mais do que deveria. Boa parte dos meus projetos pessoais roda numa hospedagem compartilhada com cPanel, e por anos o fluxo para descobrir um problema foi este: entrar no cPanel, abrir o gerenciador de arquivos, achar o error_log da pasta certa, ler, corrigir, apagar o arquivo e torcer.
O primeiro remendo foi dentro do Projects Monitor, o serviço que acompanha toda a minha infraestrutura: um scanner que varre os error_log da hospedagem e uma tabela messages para onde algumas aplicações mandavam mensagens específicas. Resolveu metade do problema. A outra metade ficou exposta:
- Erro transacional não aparece no
error_log. Uma cobrança que falhou, um webhook que chegou fora de ordem, uma API externa que respondeu 502 — nada disso é um erro do PHP. Precisa nascer estruturado, com contexto, no momento em que acontece. - Nem tudo roda no cPanel. Os serviços nas VMs da Oracle Cloud — em .NET, em shell, em PHP fora da hospedagem — não têm o mesmo
error_logpadrão. Cada um logava de um jeito, em um lugar.
A tabela messages do Projects Monitor nunca foi pensada para ser uma ferramenta de log geral. Não tinha busca decente, não tinha retenção, não tinha live tail. Era uma caixa onde as coisas caíam.
De onde vem o LogStream
O LogStream não saiu do nada. Ele é a quarta ou quinta encarnação de uma ideia que me acompanha desde o primeiro emprego.
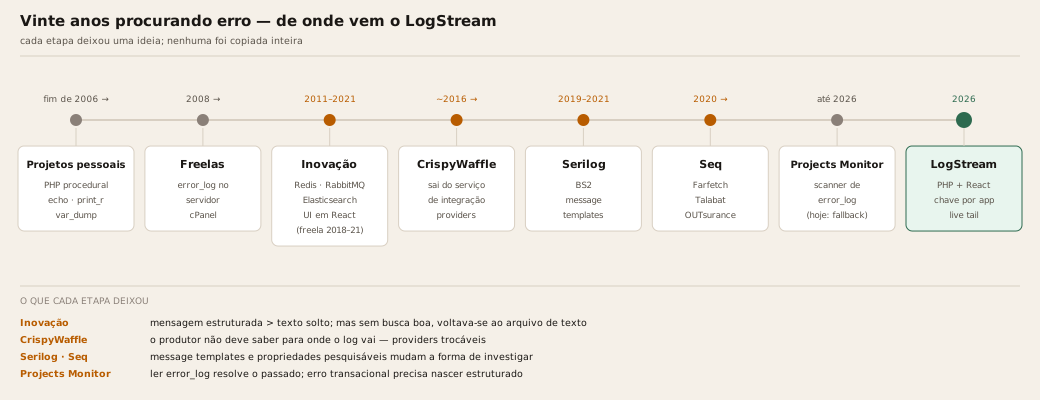
Inovação (2011–2021): Redis, RabbitMQ e Elasticsearch — ao mesmo tempo
Passei quase sete anos como funcionário da Editora Inovação (Inovação Media Brasil), de 2011 a 2018, boa parte deles como o principal — às vezes o único — desenvolvedor, e continuei atendendo a empresa como freelancer até 2021. O maior produtor de mensagens era o Integração Service — a aplicação .NET que sincronizava o ERP Sankhya com a plataforma de e-commerce VTEX e conectava os outros sistemas do grupo —, mas todos os projetos internos e externos, hospedados na Locaweb ou em servidores dentro da própria empresa, mandavam mensagens estruturadas para três destinos: Redis (pub/sub), RabbitMQ e Elasticsearch. Uma UI em React consumia o Redis e o RabbitMQ para mostrar as mensagens em tempo real, e o Elasticsearch alimentava relatórios e gráficos.
Vou ser honesto: eu joguei log nas três ferramentas ao mesmo tempo porque queria aprender cada uma delas — e porque queria colocá-las no currículo como "usei em produção". Foi overengineering puro. No fim, acabei tirando proveito de cada uma: pub/sub para o tempo real, fila para não perder mensagem, Elasticsearch para relatório. Mas a lição mais importante veio do que não funcionou: quando dava problema de verdade, quase sempre eu acabava abrindo os arquivos de log em texto no servidor. A mensagem estruturada atendia a mim e um pouco à equipe; a busca boa, que faria a gente largar o arquivo de texto, nunca chegou.
O código daquela UI (o repositório Notifications) continua privado — por um motivo nada nobre: ele guarda segredos no próprio código, de uma época em que eu ainda não usava variáveis de ambiente, muito menos um cofre de segredos.
CrispyWaffle (~2016 →): o produtor não sabe para onde o log vai
O CrispyWaffle nasceu dentro do Integração Service: era o toolkit .NET dele, incluindo a parte de log. Depois passou a servir todos os projetos .NET da Inovação e, por volta de 2016, eu o tornei open source — a partir daí ele foi parar também em freelas meus e em projetos de terceiros. A ideia central do módulo de logs é a separação entre quem produz a mensagem e para onde ela vai: o código chama o log, e uma lista de providers decide o destino — console, arquivo de texto com rotação, Redis pub/sub, RabbitMQ, Elasticsearch, Event Log do Windows, Log4Net. O formato da mensagem (LogMessage) já carregava aplicação, categoria, nível, host, IP, processo, thread e uma “operação” para agrupar mensagens relacionadas.
Serilog (2019 →) e Seq (2020 →): message templates mudam o jogo
Conheci o Serilog no BS2, onde trabalhei de 2019 a 2021. O Seq veio logo depois: na Farfetch, do fim de 2020 ao começo de 2021, na Talabat, de 2021 a 2023, e na OUTsurance, aqui em Dublin, de 2023 até hoje — quase quatro anos de uso diário. O conceito que mais mudou a minha forma de investigar problema foi o de message templates: você escreve "Charge failed for invoice {InvoiceId}", e a ferramenta guarda tanto a frase renderizada quanto o template e cada propriedade separadamente. Dá para achar todas as ocorrências daquela linha de código, independentemente dos valores, e filtrar por qualquer propriedade.
O LogStream se baseia bastante no Seq — não copiando, mas usando como referência alguns filtros e formas de exibir os logs, adaptados ao que eu preciso e corrigindo coisas do Seq que, pessoalmente, não me agradam.
Por que não usar o Seq (ou ELK, ou Loki)?
Essa é a pergunta certa, e a resposta tem uma parte técnica e uma parte que é só minha.
A parte técnica é hardware. O LogStream roda numa VM micro da Oracle Cloud, do shape gratuito VM.Standard.E2.1.Micro: 1/8 de OCPU garantido — o Linux enxerga 2 vCPUs, e a Oracle permite usar CPU adicional quando há sobra no host, mas o que está garantido é um oitavo de um núcleo — e 1 GB de RAM, dividida com outros serviços. A documentação do próprio Seq pede, para cargas leves — poucos eventos por segundo, retidos por 30 dias —, no mínimo 2 núcleos e 3,5 GB de RAM, e recomenda rodá-lo numa máquina dedicada, porque ele tenta usar toda a memória e CPU disponíveis. Elasticsearch é ainda mais faminto. Não cabe.
A parte que é só minha pesou tanto quanto:
- Escolher cada peça da stack. PHP, que eu domino há duas décadas; o MariaDB que eu já tenho na hospedagem; nada de JVM, nada de container obrigatório.
- Não depender de terceiros para evoluir. Se eu quero um filtro novo, eu escrevo. Não abro uma issue e espero um pull request ser aceito.
- Aprender fazendo. Eu sempre tive esse perfil: construir do zero para entender como funciona por dentro. O LogStream me obrigou a pensar em ingestão, indexação, retenção e streaming de um jeito que usar o Seq nunca obrigaria.
- Diversão. Criar uma ferramenta própria, depois de tantos anos usando as dos outros, é motivação suficiente para um projeto pessoal.
Como ele funciona
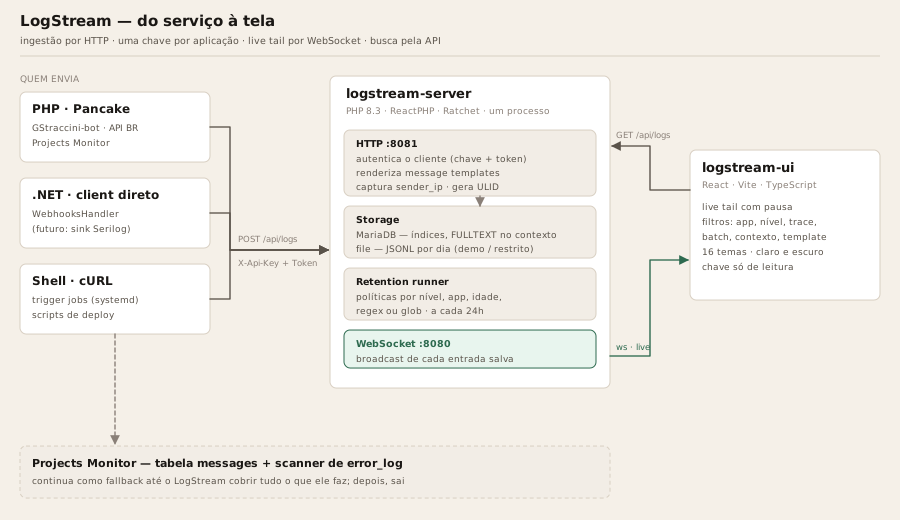
O servidor é um único processo PHP rodando em loop de eventos com ReactPHP: um servidor HTTP para ingestão e busca e um servidor WebSocket (Ratchet) para o live tail, no mesmo processo. Cada entrada salva é transmitida na hora para todas as UIs conectadas.
Ingestão por HTTP. Escolhi HTTP porque era o mais simples e rápido de implementar, seguindo os padrões que eu já conhecia — o mesmo modelo do logger do Projects Monitor. Um POST /api/logs aceita uma entrada ou um lote:
{
  "app_key":  "billing-api",
  "app_id":   "production",
  "batch_id": "550e8400-e29b-41d4-a716-446655440000",
  "logs": [
    {
      "level":    "error",
      "category": "payments",
      "message":  "Charge failed for invoice {invoice.id}",
      "context":  { "invoice": { "id": 1234 }, "code": "card_declined" },
      "trace_id": "6ba7b810-9dad-11d1-80b4-00c04fd430c8"
    }
  ]
}
Eventos no estilo Serilog. A message pode ser um template: os placeholders apontam para chaves do context (inclusive aninhadas, com ponto), o servidor renderiza a frase e guarda o template original em message_template. Placeholder que não resolve fica como está — mensagens que têm chaves por outro motivo não são estragadas. Cada entrada ganha um ID ULID, ordenável por tempo, e o IP de quem enviou, capturado pelo servidor (com suporte a proxies confiáveis).
Dois modos de storage. O primeiro foi o file mode: um arquivo JSONL por dia, o mais fácil de colocar de pé numa máquina de testes e na VM onde ele ficou no início. Logo depois veio o MariaDB — o mesmo que eu já tenho na hospedagem —, que trouxe o que faltava para virar um sistema de verdade:
- uma chave e um token por aplicação (
X-Api-Key+X-Api-Token), em vez de um segredo compartilhado; - filtros apoiados em índice, incluindo busca de texto no
contextcom índice FULLTEXT e filtroscontext[order.id]=42por propriedade; - políticas de retenção por nível, aplicação, ambiente, idade, regex ou glob — aplicadas tanto à mensagem renderizada quanto ao template.
Hoje o file mode serve para a demo e para ambientes restritos que não precisam de banco.
Retenção declarada em JSON. As políticas ficam num arquivo de configuração, e o servidor as aplica a cada interval_hours. Cada política combina filtros — nível, aplicação, ambiente, regex ou glob na mensagem — com uma idade mínima, e o que casar com todos os filtros é apagado. Um trecho do retention.example.json do repositório:
{
  "enabled": true,
  "interval_hours": 24,
  "policies": [
    { "name": "remove-debug-7d", "level": "debug", "older_than_days": 7 },
    { "name": "remove-production-info-30d", "app_id": "production", "level": "info", "older_than_days": 30 },
    { "name": "remove-pii-email-regex-1d", "message_regex": "[a-zA-Z0-9._%+\\-]+@[a-zA-Z0-9.\\-]+\\.[a-zA-Z]{2,}", "older_than_days": 1 }
  ]
}
A primeira limpa o debug depois de uma semana, a segunda segura o info de produção por 30 dias, e a terceira apaga em um dia qualquer mensagem que contenha um e-mail — retenção também serve para não guardar dado pessoal sem necessidade. Como regex e glob são aplicados tanto à mensagem renderizada quanto ao template, dá para mirar uma linha de log inteira, independentemente dos valores: "message_glob": "GitHub {event}*" pega todos os eventos de webhook do GitHub de uma vez.
Leitura e escrita separadas. Quem envia log usa a chave de escrita; a UI usa só uma chave de leitura. Uma UI comprometida não consegue injetar log, e um serviço comprometido não consegue ler o log dos outros.
A interface
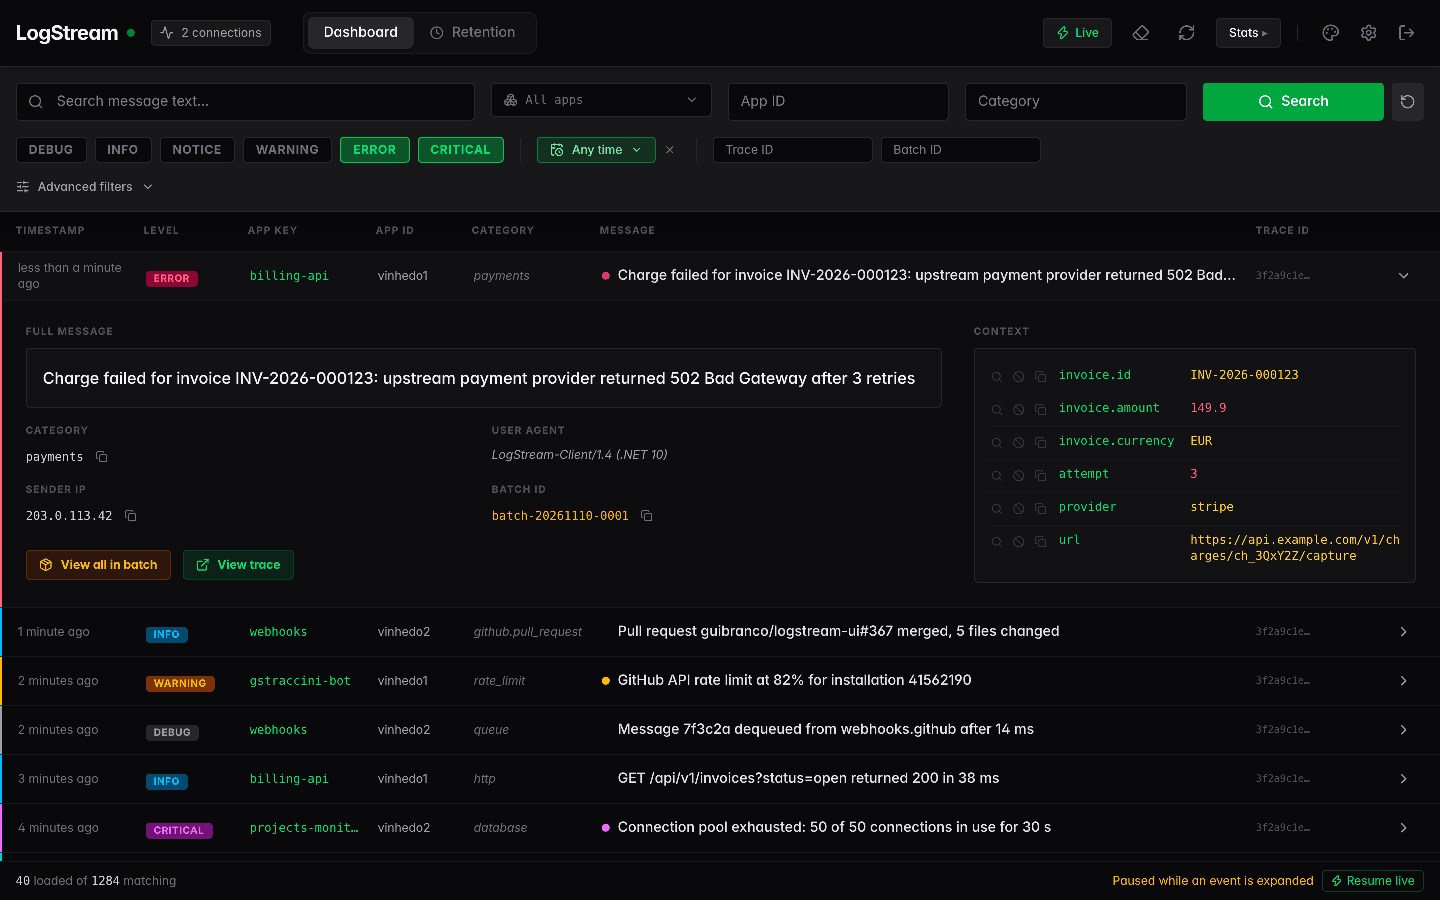
A logstream-ui é um app React + Vite + TypeScript hospedado no GitHub Pages, sem nenhuma configuração em tempo de build: a URL da API, a do WebSocket e a chave de leitura são informadas numa tela de configuração e ficam no navegador. As capturas abaixo usam dados fictícios.
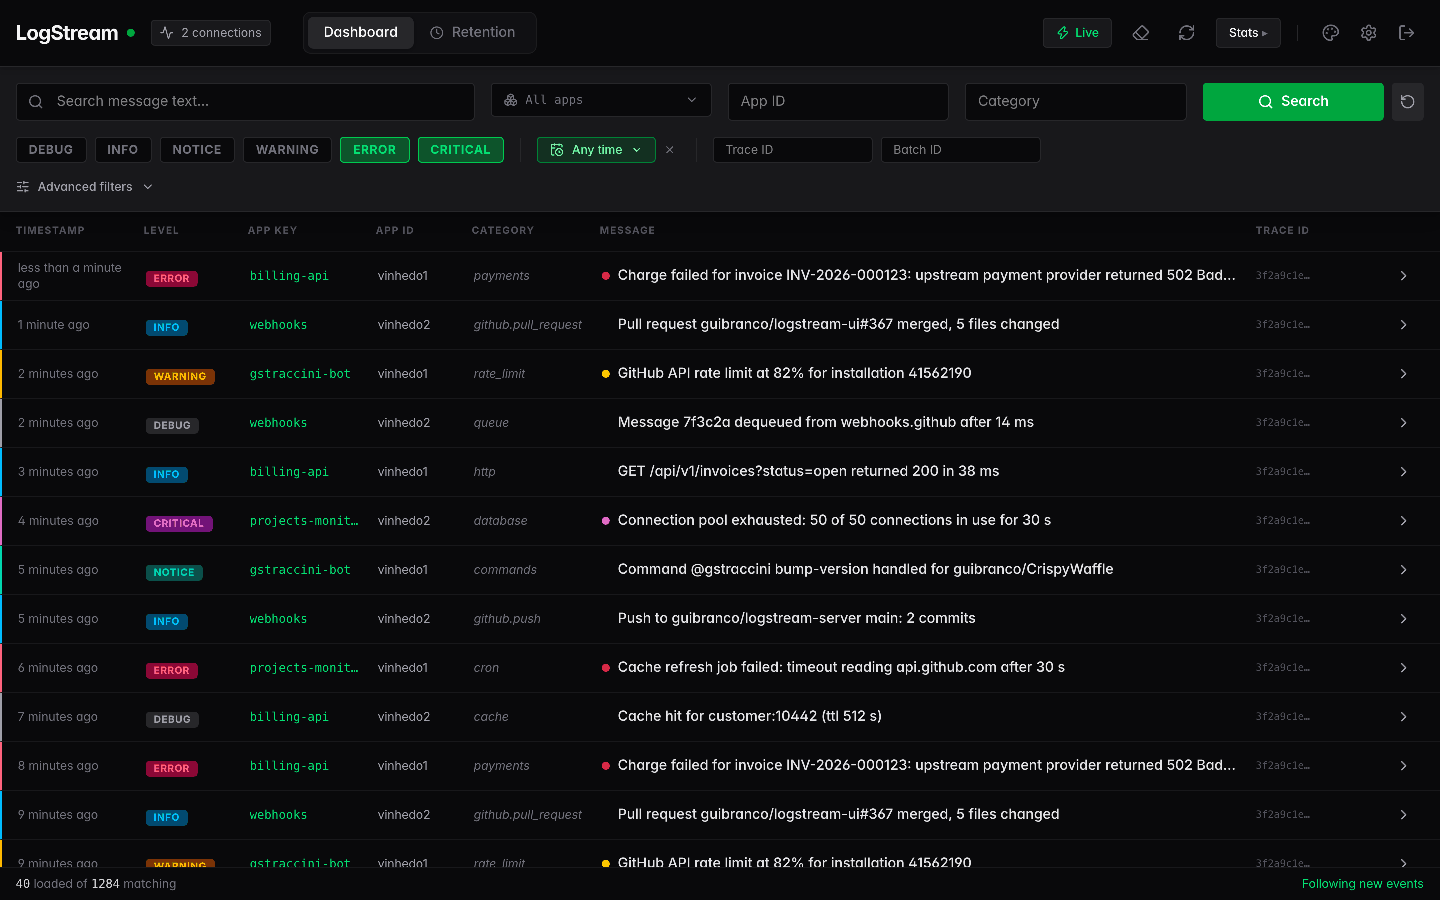
O que eu mais uso no dia a dia:
- Live tail com pausa. Novas entradas entram em tempo real; ao expandir uma, o fluxo pausa para a tela não andar debaixo do mouse.
- Propriedades do contexto como filtros. Cada valor do
contexttem Find e Exclude — o atalho que eu mais sentia falta de ter num clique só. - Navegação por lote e por trace. Um clique mostra todas as entradas do mesmo
batch_idou do mesmotrace_id. - Filtros avançados por texto no contexto, por
chave = valore por message template. - Desempenho e conforto. Virtualização de linhas para listas grandes e 16 temas, cada um com variante clara e escura.
Os clientes
Hoje, três jeitos de mandar log para o LogStream convivem na minha infraestrutura.
PHP, pelo Pancake. Meu toolkit PHP ganhou uma classe LogStream, usada pelo GStraccini-bot, pelas APIs do API BR e pelo próprio Projects Monitor.
O uso é assim:
use GuiBranco\Pancake\LogStream;

$logs = new LogStream(
    baseUrl:  'https://logs.example.com',
    appKey:   'billing-api',
    appId:    'production',
    authMode: LogStream::AUTH_API_KEY,
    apiKey:   'billing-api',
    apiToken: getenv('LOGSTREAM_TOKEN'),
);

$logs->error('Charge failed for invoice {invoice.id}', [
    'invoice' => ['id' => 1234],
    'code'    => 'card_declined',
], 'payments');
.NET, direto no WebhooksHandler. Por enquanto é um cliente simples dentro do serviço que processa os webhooks do GitHub. O destino natural é virar um sink do Serilog — ou um provider do CrispyWaffle, ou um pacote NuGet próprio. Ainda não decidi.
Shell, com cURL. Os jobs que rodam como serviço do systemd mandam log com uma linha:
curl -sS -X POST "$LOGSTREAM_URL/api/logs" \
  -H "X-Api-Key: trigger-jobs" -H "X-Api-Token: $LOGSTREAM_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"app_key":"trigger-jobs","app_id":"production","level":"info","message":"tick"}'
Quando deu errado
O LogStream ficou parado de agosto até o último domingo, 08/11/2026. O motivo foi o file mode: a VM micro, que já era dividida com outros serviços, não aguentou a carga de escrita em disco. O sistema travava sem responder e, algumas vezes, o processo foi morto pelo OOM killer do Linux.
Também não descarto que parte da carga tenha vindo de tráfego que não deveria estar lá, numa época em que eu testava muita coisa em paralelo. Isso pesou diretamente em duas decisões: o modelo de chave e token por aplicação e o rate limit por cliente, que está no backlog.
No domingo, ele voltou rodando sobre o MariaDB. Desde então já passou de 1 milhão de mensagens — e não por acaso. Nos meus repositórios, o Dependabot está configurado como weekly sem dia definido, e nesse caso ele roda às segundas-feiras, num horário que o próprio GitHub escolhe. Na prática, a onda começa por volta da meia-noite de domingo para segunda, segue durante a segunda e tem um segundo pico no fim do dia, já quase terça. Cada pull request aberto gera uma cascata de webhooks, processamento e automação no GStraccini-bot. E a onda não termina quando o Dependabot para: muitos desses PRs dependem de outro ser mesclado antes para então serem atualizados, o que forma uma fila por repositório. O GStraccini-bot vai consumindo essa fila ao longo do dia seguinte — atualizações, correções de code smells, reviews —, e cada passo dispara mais webhooks, horas depois de o PR ter sido aberto. O servidor segurou bem essa primeira onda.
O banco não mostra esse milhão inteiro, porque eu truncei a tabela algumas vezes enquanto testava. A janela limpa mais recente — 24 horas, de 10/11/2026 às 00h31 até 11/11/2026 às 00h44 (UTC), uma terça-feira, ainda na cauda da onda do Dependabot — já conta a história. Para comparar, deixei também a manhã de quarta-feira, fora da onda:
| Métrica | Valor |
|---|---|
| Entradas em ~24 h | 337.539 |
| Média | ~3,9 por segundo |
| Quarta inteira, 11/11 (fora da onda) | 96.877 · ~1,1 por segundo |
| Pico (10/11, das 09h00 às 10h00) | 27.406 em uma hora · ~7,6 por segundo |
Aplicação que mais envia (webhooks) | 311.105 · 92,2% |
info + debug | 99,3% |
error + critical | 50 · 0,015% |
| Tamanho médio: mensagem / contexto | 80 bytes / 398 bytes |
| Tamanho da tabela | 626,9 MiB · ~1,9 KB por linha |
Três coisas saltam desses números:
- “Poucos eventos por segundo” é exatamente a minha carga. É a faixa que a documentação do Seq chama de leve — e para a qual ela pede 2 núcleos e 3,5 GB de RAM.
- O problema não é volume, é ruído. Nove em cada dez entradas são o serviço de webhooks registrando, em
info, cada evento que passa por ele. Os 50 erros e críticos que importam estão afogados em 337 mil linhas. É por isso que amostragem e retenção por aplicação estão no topo do backlog. - O disco custa quatro vezes o conteúdo. Uma entrada tem, em média, 478 bytes de conteúdo, mas ocupa ~1,9 KB no disco. Pelo
SHOW TABLE STATUS, ~1,1 KB disso é a própria linha no InnoDB e ~0,8 KB são os oito índices e o FULLTEXT do contexto — ou seja, quase metade do espaço (42%) é índice. Sem retenção, isso dá entre ~180 MB por dia num dia calmo como a quarta e ~600 MB num dia de onda: algo entre 5 e 18 GB em 30 dias. Numa hospedagem compartilhada, retenção não é opcional — e ela já está trabalhando: hoje rodam duas políticas, uma que apagadebugcom mais de 1 dia e outra que apaga qualquer entrada com mais de 7 dias. Só a primeira já tirou ~25 mil entradas dedebugda terça.
E o processo em si? Medi na quarta-feira à noite (11/11/2026, 21h52), com o servidor de pé havia 28 horas — desde o fim da tarde de terça, ainda na cauda da onda:
- Memória: ~36 MB residentes, e o pico registrado desde que o processo subiu é o mesmo valor — ou seja, em nenhum momento dessas 28 horas ele passou de 36 MB.
- CPU: 0,1% de média nessas 28 horas. Em 12 amostras de 5 segundos, ficou entre 0,0% e 0,4%.
- A VM inteira: 952 MB no total, ~714 MB disponíveis e swap zerado. O LogStream é só o quarto processo que mais usa memória na máquina — o journal do systemd usa quase três vezes mais.
Não é uma comparação de igual para igual: os 3,5 GB do Seq são o mínimo recomendado para a máquina inteira, e os 36 MB são a memória medida de um processo — sem contar o MariaDB, que roda em outro servidor. Mas é o número que importava para a minha decisão: o LogStream cabe com folga numa VM de 1 GB, e o Seq, pela própria documentação, não. O que derrubou o servidor em agosto nunca foi o processo; foi o disco.
Escrevendo este post, achei dois bugs
Ao conferir os números da retenção, a tabela retention_log estava vazia. A limpeza acontecia, mas nada era registrado — e, pior, a linha de comando ignorava as políticas criadas pela UI e lia só o arquivo JSON, que em produção estava vazio. Investigando isso, encontrei um problema bem mais sério: o botão “Simular exclusão” da interface mandava o dry_run no corpo da requisição, e o servidor só lia esse parâmetro da query string. Toda simulação rodava todas as políticas de verdade. Uma simulação apagava dados.
É o tipo de bug que uma ferramenta madura dificilmente teria — e é o preço de construir a sua. Mas o outro lado da moeda apareceu na mesma manhã de quinta-feira, 12/11/2026:
| Horário | O que aconteceu |
|---|---|
| 11h05 | Aberto o #118: registro de cada execução na retention_log e políticas do banco também na linha de comando |
| 11h08 | #118 mesclado — 14 arquivos, 417 testes passando |
| 11h13 | Primeira correção em produção |
| 11h26 | Aberto o #119: o dry_run passa a valer também no corpo da requisição, e o prune.php recusa argumentos |
| 11h34 | #119 mesclado — seis dos testes novos falhavam contra a main antes da correção; 427 testes passando |
| 11h37 | Segunda correção em produção |
Do primeiro pull request aberto à segunda correção em produção, foram 32 minutos. Os dois PRs foram escritos com o Claude Code; eu revisei, o GStraccini-bot aprovou, o CodeRabbit revisou o segundo, e o deploy saiu automático a cada merge. Sem issue esperando triagem num projeto de terceiros, sem depender de ninguém além de mim — que, hoje, também sou o único usuário.
Enquanto isso, a tabela messages do Projects Monitor continua viva como fallback. Ela só sai quando o LogStream cobrir tudo o que ela faz — migração gradual, sem big bang.
O que eu perdi, o que eu ganhei
| Critério | LogStream | Seq | ELK |
|---|---|---|---|
| Roda numa VM micro (1/8 OCPU, 1 GB) | ✓ | ✗ | ✗ |
| Message templates e propriedades | ✓ | ✓ | ~ |
| Live tail | ✓ | ✓ | ~ |
| Busca rápida em volume grande | ~ | ✓ | ✓ |
| Dashboards e alertas | ~ planejados | ✓ | ✓ |
| Maturidade e comunidade | ✗ | ✓ | ✓ |
| Evolui no meu ritmo, na minha stack | ✓ | ✗ | ✗ |
Sinceramente, até agora não sinto falta de nada no dia a dia. Parte disso é que eu uso o Claude Code para tirar da frente o trabalho repetitivo, o que me dá liberdade para fazer o que eu quiser na velocidade que eu quiser. A outra parte é que o que falta já está desenhado: entre server e UI, são algo entre 10 e 20 funcionalidades planejadas, abertas como issues.
Próximos passos
E um banco feito para logs?
Hoje o LogStream guarda tudo num MariaDB comum, e a seção 07 mostrou o preço: cada entrada ocupa no disco quatro vezes o próprio conteúdo, e quase metade disso é índice. Existem bancos pensados especificamente para isso, e eles resolvem o problema de formas bem diferentes:
| Banco | Como indexa | Encaixa no LogStream? |
|---|---|---|
| VictoriaLogs | Schemaless: recebe cada entrada como JSON e guarda cada campo em blocos separados, sem configurar schema nem índice | ✓ o candidato natural — casa com o modelo de propriedades livres no estilo Serilog e roda como um binário único |
| Grafana Loki | Indexa só os labels (app, ambiente); o conteúdo da mensagem é varrido como um grep | ~ barato, mas a busca por propriedade do contexto, que eu mais uso, fica lenta |
| ClickHouse | Banco colunar genérico, muito rápido em agregações | ~ funciona bem quando os campos e as consultas são conhecidos de antemão — o oposto de um contexto livre |
| InfluxDB / TimescaleDB | Séries temporais, pensadas para métricas numéricas | ✗ log é texto com contexto, não número no tempo |
O plano é tratar isso como mais um modo de storage atrás da mesma API, como já acontece com o file mode e o MariaDB: os clientes e a UI não precisariam saber que o banco mudou. A própria equipe do VictoriaLogs afirma que ele costuma precisar de menos RAM e disco que o Loki para o mesmo volume de logs — algo que eu ainda quero medir na minha VM antes de decidir.
Várias dessas issues estão marcadas como good first issue e help wanted nos dois repositórios. Se quiser contribuir, é por lá.
Ferramenta pronta é quase sempre melhor. Quase.
O LogStream não compete com o Seq, nem quer competir. Ele existe porque eu tinha uma restrição real de hardware, um problema específico — erro transacional e serviços espalhados fora da hospedagem — e vinte anos de vontade de entender como as coisas funcionam por dentro. Cada etapa deixou uma ideia: a Inovação me ensinou que mensagem estruturada vale mais que texto solto, o CrispyWaffle que o produtor não deve saber para onde o log vai, e o Seq que message templates mudam a forma de investigar.
Se você está pensando em fazer o mesmo, a minha recomendação continua sendo usar uma ferramenta pronta. Mas, se a conta fechar para você — pelo hardware, pelo aprendizado ou pela diversão —, os dois repositórios estão abertos.
Referências
- guibranco. logstream-server. github.com
- guibranco. logstream-ui. github.com
- guibranco. Integração Service — documentação. guilherme.stracini.com.br
- guibranco. CrispyWaffle — módulo de logs. github.com
- guibranco. Pancake — LogStream. guibranco.github.io
- Datalust. Seq — System Requirements. datalust.co
- GitHub. Configuration options for the dependabot.yml file. docs.github.com
- Oracle. Always Free Resources. docs.oracle.com
- Message Templates. messagetemplates.org
- VictoriaMetrics. VictoriaLogs — FAQ. docs.victoriametrics.com
- ITNEXT. Why VictoriaLogs is a better alternative to Grafana Loki? itnext.io
- ReactPHP. reactphp.org · Ratchet. socketo.me
Categorias